组员日常问答整理
MySQL
MySQL为什么使用B+树而不是B树作为索引?
廖银华
B树的叶子节点没有指针,B+树有,有指针可以更加方便范围查询
B+树是三层,B树可能更高。
王静
1.B+树非叶子结点不存储数据,B树非叶子结点存储数据,相同数据量B+树的高度更低,查询更快。
2.B+树叶子节点之间使用双向指针连接,更方便遍历数据,范围查询更快。
王天鑫
b+树叶子节点有指针 范围查询更快,b+树只有叶子节点存数据,一个页可以存更多的数据 效率更高
张启航
B+树非叶子结点不储存数据,每层可以存放多的结点,叶子结点之间有指针连接
张煜浩
b+树非叶子结点只存储索引,不存储data,一个索引页可以存储更多的索引项,相比b树来说,存储数据量一样大时,b+树的高度可能更低,查找效率也就可能更高。b+树的叶子节点之间使用双向指针连接,提高了区间访问的效率。
赵哲
1、非叶子节点只存储索引,每页16kb大小可存储更多索引。2、叶子节点间使用双向指针链接,提高叶子间访问的速度。
小雪
B+比B树更支持范围查询
阿紫
表中相邻记录在磁盘上是顺序存储呢?还是随机分布的呢?
廖银华
王静
相邻行可能存储在不同的页上面,不同页通过指针连接,物理层面上地址不一定相连
一页以内的数据相邻行物理相连,但是页与页之间也有相邻行啊,一页数据放满了,这个时候新增了一个数据索引在这页范围内,这页放不下了,页就会产生分裂,新增行以及这一行索引后面的数据就放到新的页里面去了呀,然后修改页与页的指针关系
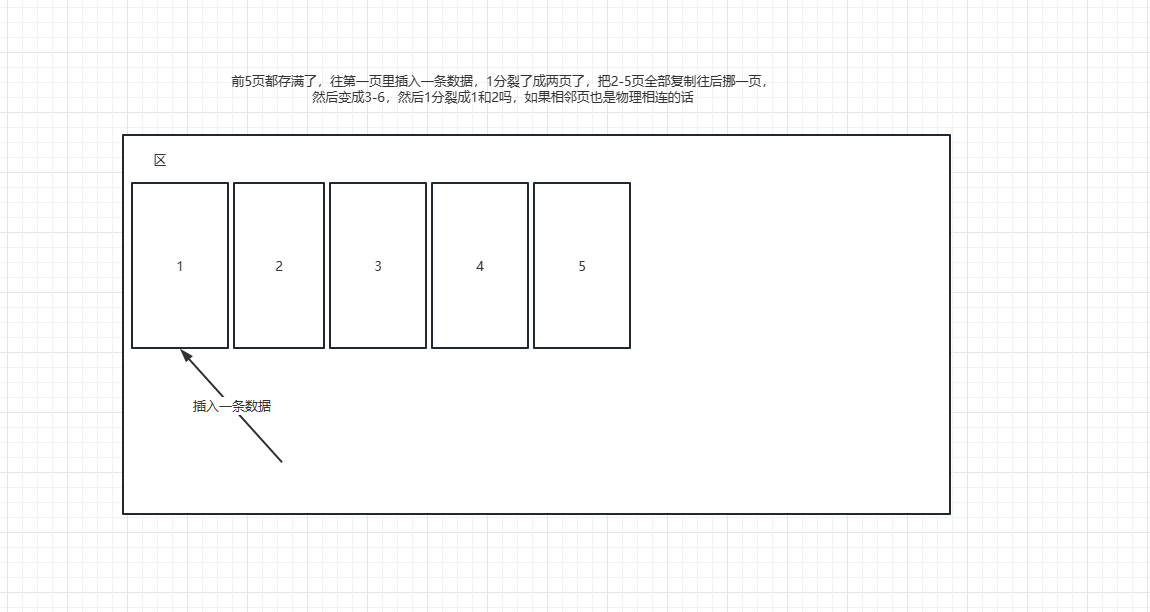
王天鑫
表中想临需要看是否按聚簇索引排序了 如果排序后相连 物理磁盘上有大概率相连,反之则是大概率不相连
张启航
张煜浩
实际上磁盘存储还是以页为单位,区、段这些都是逻辑概念哈。一页中的数据是顺序存储的,页与页之间可能就随机存储了
赵哲
阿紫
页里的数据是顺序存储的,行数据在页里面是相邻的,如果分页了,可能就不相邻。尽可能做到局部连续。
为什么不建议用uuid做为主键,推荐使用自增id做为主键?
廖银华
uuid相对于自增空间消耗更多,且无序,新增数据维护索引树会频繁调整树结构导致效率大打折扣,在插入过程会挪移部分数据到新的数据页。
王静
避免导致频繁的叶的分裂
王天鑫
UUID字段长浪费空间,B+树的索引插入数据时需要比较字符串大小,自增id是数字进行比较,查询和插入效率高 应该是这么回事…
张启航
往表里新增数据本质上就是想主键索引B+树上增加数据,uuid在计算索引比较大小的时候比自增id慢,uuid由于是无序的,插入时叶子节点可能要维护两个双向列表,自增节点则不会
张煜浩
使用自增id:节约磁盘空间+避免叶分裂造成树结构调整带来的性能消耗。
赵哲
因为uuid新增数据的话,可能导致,新增的id需要插入到已经排好的页中,导致叶子重新分类排序
阿紫
数据库从哪些方面优化
MySQL优化,一个是硬件方面的,一个是软件方面。先说硬件方面的,有没有把CPU的负载压到到90%以上?内存使用有没有压榨到只剩几个G,IO打满没有?
CPU的使用率可以通过调整线程,包括数据库的最大连接数,业务层这边的连接池。
内存使用可以调整buffpool,jionbuffer, sortbuffer
软件方面的,又分为两个方面,一个是数据库的服务端,一个是应用的业务端。
mysql主要是优化索引,还有做大表化小表之类的。优化索引所以我就不说了😂大表化小表的话,可以水平拆分,垂直拆分,最简单的就是做数据迁移历史数据备份。
客户端这边的话就是优化sql,优化表结构,主要是分析业务,还有读写分离。
JVM
分代收集理论的含义和作用?
廖银华
将堆划分成不同区域,将对象根据年龄分到不同的区域。回收在年轻代和老年代可以选择不同算法,复制比标记整理或标记清楚快得多。
王静
根据新生代和老年代的特点,使用不同的垃圾回收算法进行回收
王天鑫
把java堆分为老年代与新生代,根据不同代使用不同的垃圾回收算法 提高垃圾回收的效率
张启航
根据对象的不同周期把内存分开,jvm分为老年代和新生代,可以选择不一样的垃圾收集算法
张煜浩
对象的存活周期不一样,所以内存分为了年轻代和老年代。分代收集就是根据各个年代的特点选择合适的垃圾收集算法。年轻代大多是朝生夕死的对象,所以可以采用复制算法,成本较低。标记清楚/标记整理算法较复制算法会慢10倍以上。。总之就是为了提高垃圾回收的效率
赵哲
因为在程序运行中大部分的对象都是朝生暮死的。所以将回收对象根据年龄分配到内存中。方便针对老年代,新生代进行垃圾回收。减少full gc.
阿紫
分代收集理论是一种思想。
根据对象的存活周期,将对象归为了两类:用完即毁存活时间短的对象和长期存活的对象。
以此将堆划分了两个区域:年轻代和老年代。
年轻代采用复制算法,故又分为了Eden区和Survivor区。
老年代采用标记清除或标记整理算法。由于标记清除算法存在大量的内存碎片,故多采用标记整理算法或两种算法同时使用。
基于对象的特点采用不同的算法,以此提高垃圾回收的效率。
CMS垃圾收集器的gc过程是怎样的?
廖银华
分为四个步骤
1、初始标记:(STW),标记Gc Root能直接引用的对象。
2、并发标记:遍历整个对象引流树,过程较长,但不用STW。(发生变化的对象后面重新标记)
3、重新标记:修正并发标记阶段因为没有STW而产生变化的对象。(三色算法还没搞透)
4、并发清理:对未标记(白色)的区域直接清理。有新增的对象会被标记成黑色(还是三色),结束后重置对象颜色(重置标记)
这四个步骤中并发标记会多标。(并发清理我认为整个标记阶段已经结束了?这个阶段不应该存在“多标”的意义。),重新标记会漏标
王静
初始标记:STW,标记gc roots直接引用的对象
并发标记:从gc roots直接引用的对象开始遍历标记其他对象
重新标记:STW,修正并发标记期间,程序运行时变动的标记
并发清理:开启GC线程对未标记的对象做清扫。这个阶段如果有新增对象会被标记为黑色不清理
并发重置:重置GC清理的标记
漏标会发生在并发标记和并发清理的阶段,两种情况:新增对象、已扫描对象插入未扫描对象引用关系
1.新增对象:比如产生新的gc roots,处理办法是将新增对象标记为黑色不处理
2.已扫描对象插入未扫描对象引用关系:处理办法增量更新或写屏障
多标会发生在并发标记和并发清理阶段(比如已标记过的对象失去所有引用变为不可达),多标的对象为浮动垃圾,下次再清理
王天鑫
多标发生在并发标记、并发清理:刚标记为存活的对象,此时线程执行结束可达性根节点销毁,被引用的对象变为多标-浮动垃圾。
漏标发生在并发标记:黑色对象一旦新插入了指向白色对象的引用之后, 它就变回灰色对象了,灰色对象可能有未扫描到的对象,发生漏标。
张启航
初始标记:GCroot直接引用的对象,stw但是非常快;。 并发标记,根据GCroot遍历寻找存活对象,和用户线程一起运行;。 重新标记,stw用于将并发标记期间改变的对象重新修改,用了增量更新算法,写屏障,源码中发生在给对象赋值操作后;。 并发清除:清除未被标记的对象,不stw;。 并发重置,重置本次GC的标记。
多标会发生在并发标记和并发清理阶段,会产生浮动垃圾,漏标会发生在并发标记阶段,因为标记线程和用户线程一起运行,比如灰色对象的没有被扫描到的白色属性,被断了引用,被断了引用的白色对象被另一个黑色对象引用,那么白色对象存在漏标问题,cms用增量更新算法来解决漏标问题
张煜浩
初始标记:STW,标记gc roots直接引用的对象,速度很快。
并发标记:用户线程和垃圾收集线程并发运行,根据gc roots对象图遍历标记所有对象。
重新标记:STW,修正并发标记过程产生的多标、漏标、新增对象问题,主要是解决漏标问题。
并发清理:用户线程和垃圾收集线程并发执行,将未标记对象清除。
并发重置:用户线程和垃圾收集线程并发执行,清除本次gc过程的标记信息。
赵哲
阿紫
初始标记:STW,标记gc roots直接引用的对象,速度很快。
并发标记:用户线程和垃圾收集线程并发运行,从gc roots直接引用的对象开始遍历标记其他对象。
重新标记:STW,修正并发标记期间,产生的多标、漏标问题。
并发清理:用户线程和垃圾收集线程并发执行,将未标记对象清除,这个阶段如果有新增对象会被标记为黑色不清理
并发重置:用户线程和垃圾收集线程并发执行,清除本次gc过程的标记信息。
漏标会发生在并发标记和并发清理的阶段,两种情况:新增对象、已扫描对象插入未扫描对象引用关系
1.新增对象:比如产生新的gc roots,处理办法是将新增对象标记为黑色不处理
2.已扫描对象插入未扫描对象引用关系:处理办法增量更新或写屏障
多标会发生在并发标记和并发清理阶段(比如已标记过的对象失去所有引用变为不可达),多标的对象为浮动垃圾,下次再清理
JVM 有哪些垃圾回收算法
廖银华
王静
1.复制算法:将内存分为大小相同的两块,每次使用其中一块,当这块内存使用完后,将存活对象复制到另一块内存,原来的内存区域清理掉。适合新生代,每次收集死亡对象都很多的情况。缺点:内存浪费。
2.标记清除算法:先标记所有存活的对象,然后将未标记的对象回收。缺点:会产生很多内存碎片。
3.标记整理算法:先标记所有存活的对象,然后将所有存活的对象移动到一端,清除没有存活对象的区域。缺点:效率低。
王天鑫
垃圾回收算法共三种: 新生代使用标记-复制、
老年代使用:标记-整理、标记-清除算法
张启航
1.复制算法:将内存分为大小相同的两块,每次使用其中一块,垃圾回收时,将存活对象复制到另一块内存,原来的内存区域清理掉。适合新生代,速度快,内存利用率低
2.标记清除算法:先标记所有存活的对象,然后将未标记的对象回收。cms垃圾回收算法的,会产生大量内存碎片,cms可以配置几次fullgc后整理一次内存
3.标记整理算法:先标记所有存活的对象,然后将所有存活的对象移动到一端,清除边界以外的内存。效率低,不会产生内存碎片
张煜浩
标记复制算法 /标记清除算法/ 标记整理算法,三种算法都是基于分代收集理论实现的。
赵哲
阿紫
1、复制算法
按照容量划分二个大小相等的内存区域,当一块用完的时候将活着的对象复制到另一块上,然后再把已使用的内存空间一次清理掉。
优点:效率高,年轻代存活的对象少,复制很快。
缺点:内存使用率不高,只有原来的一半。
2、标记清除算法
标记存活的对象,然后将所有未被标记的对象回收。
或者:标记无用对象,然后进行清除回收
缺点:产生大量不连续的碎片,效率比复制算法低。
3、标记整理算法
标记存活的对象,让所有存活的对象向一端移动,然后直接清理掉端边界以外的内存。
或者:标记无用对象,让所有存活的对象都向一端移动,然后直接清除掉端边界以外的内存。
优点:相比于标记清除算法,空间规整,不会有内存碎片。
缺点:效率比复制算法低。
4、分代收集理论
根据对象存活周期的不同将内存划分为几块,一般是新生代和老年代,新生代基本采用复制算法,老年代采用标记整理算法。
为什么说8G以上应该用G1而不是用ParNew+CMS?
廖银华
王静
CMS对于大内存高并发场景,新生代回收速度太慢或者s区内存小于一次minor gc转移的对象大小,会频繁触发full gc甚至OOM。G1使用region分配内存,对象清理阶段使用复制算法,效率高,并且能计算每个region的回收成本,可以预估在预期停顿时间内能清理最多的region模块
王天鑫
因为g1通过regions来作为回收目标 可以预估每个regions的回收时间 来控制最大停顿时间 cms无法预估回收时间 控制不了停顿时间
张启航
8g以上CMS垃圾收集器在一次fullgc中,并发标记和并发清理阶段需要处理的垃圾对象比较多,用户线程并发运行可能产生更多垃圾造成concurrentmode failure,stw使用串行收集,G1可以通过控制最大停顿时间完成垃圾收集,根据设定的时间建立停顿时间模型。
G1在筛选回收阶段是STW,可以对的各个需要回收的region区域进行回收成本评估排序,根据用户设定的时间完成,cms如果需要控制最大停顿时间只能在初始标记和重新标记阶段,控制初始标记时间会有很多浮动垃圾导致频繁fullgc,控制重新标记时间有可能没有扫描到增量更新的对象,导致漏标bug,
张煜浩
G1在筛选回收阶段会按照设定的预期停顿值,对每个region的回收价值和成本做一个计算和排序,去优先回收部分region达到阈值,剩余未回收的浮动垃圾待下一轮gc再做筛选回收。而cms在内存过大(对象非常多)的情况下,初始标记和重新标记所耗费的时间也是比较多的,无法有效控制。
赵哲
阿紫
为什么说8G以上应该用g1而不是用ParNew+CMS?
这个问题可以反过来思考,为什么ParNew+CMS不能使用在8G以上的内存上?
这是由于传统的垃圾收集器都是将内存分配两大块:年轻代和老年代。
只有当内存满了才会进行gc,如果使用8G以上的内存就会导致一次gc要清理的垃圾实在太多了,需要停顿很长的时间。
而G1则打破了传统的划分方式,它不再局限于年轻代和老年代,而是将内存划分成了一个个内存区域,每一个区域都可以是年轻代、老年代,并且每一个内存区域在大范围内都是连续的内存空间(如2m), 一个具有10个字段的对象也就56B。
这就使得G1可以灵活的为对象分配内存空间,以及随意的进行垃圾收集,内存一块一块的,又能采用复制算法,提交垃圾收集效率。
它没有必要再像传统的垃圾收集器一样必须等8G内存满了再收集,或者一次就要清理所有的垃圾对象。
至于为什么G1可以控制停顿时间,CMS不能。
因为CMS不需要,CMS面向的是小容量的内存收集,只会在初始标记和重新标记阶段STW,在一个小容量的内存空间里,并不会存在等待很长时间的情况,而并发清理阶段又是和用户线程同步运行。
为什么CMS并发清理阶段能和用户线程同时运行?
这是因为CMS预留了一部分空间(8%),这就使得用户线程在并发清理阶段产生的对象可以放到这一部分区域里,对并发清理的过程不会造成影响。
至于G1在筛选回收阶段为什么不能和用户线程同时运行?可能是算法太过复杂或者别的什么,这一点我们无法得知。
而正是因为G1在筛选回收阶段要STW,所以就会面临和传统垃圾收集器一样的问题:8G内存的垃圾也太多了,清理内存要耗费很长的时间。那么怎么办呢?
控制停顿时间!所以对于G1可以控制停顿时间这件事,相比于说是G1的一种亮点,我倾向于是G1由于筛选回收要STW而不得已做出的优化。如果筛选回收不需要STW,又何必控制停顿时间呢~
最主要的还是G1的内存结构和其他的垃圾收集器不一样,这才能让它做到回收一部分空间的事情。
为什么JVM默认使用TLAB(本地线程分配缓冲)的方式给对象分配内存。它相比于cas的优点是什么?
廖银华
线程专属空间,避免分配内存产生空间竞争。从而相对于cas效率更高。tlab空间一般是不会太大,则较大对象肯定无法在此分配,也是tlab空间的局限性。
王静
TLAB给每个java线程分配一小块内存区域使用,避免了线程争抢内存资源。CAS虽然也能同步给多个线程分配资源,但是很有可能分配失败再重试,重试过程比较影响效率
王天鑫
TLAB 线程本地分配缓存区,这是一个线程专用的内存分配区域。
由于对象一般都分配在堆上,而堆是全局共享,因此同一时间可能会有多个线程申请空间,所以在对象分配时必须要同步进行,jvm使用tlab来避免多线程的冲突,再给对象分配内存时,每个线程使用自己的tlab,这样避免了线程冲突,提高对象的分配效率。
相比cas(失败重试的机制保证原子性)避免了多线程的冲突,提高对象的分配效率。
张启航
TLAB是每个线程开启时在Eden区分配的一块内存区域,避免多线程在内存分配时频繁加锁的场景,对比CAS失败重试可能会占用大量的cpu资源,效率不高
张煜浩
我觉得tlab分配相比cas更高效方便,是它很好的利用了虚拟机找线程私有这个特性,而cas说白了还会存在线程之间的资源争抢,性能效率都会打折扣。
赵哲
tlab线程本地缓存区 会给每一个线程分配内存使用,避免了多线程下的资源冲突。在分配内存不足时就会使用 cas的方式同步来保证原子性一致性。相比于cas,tlab避免了线程资源争抢,效率更高。但相对的对内存的要求会更高。
阿紫
什么场景适合使用G1垃圾收集器
廖银华
1大内存 多核服务器,
2超过 50% 的 Java 堆被活动数据占用
3对象分配频率或年代提升频率变化很大,GC停顿时间过长 超过1s
4STW停顿500ms以内
王静
排个优先级:
8GB以上的堆内存
对停顿时间要求很严格
对象分配和晋升的速度变化非常大(高并发)
50%以上的堆被存活对象占用
王天鑫
张启航
堆内存8g以上,和对停顿时间有要求这两个
张煜浩
堆内存超过8g,堆中存活对象内存占用超过一半以上,gc频繁且时间超过1s,预期停顿时间500ms以内
赵哲
阿紫
参考答案
a)50%以上的堆被存活对象占用
b)对象分配和晋升的速度变化非常大
c)垃圾回收时间特别长,超过1秒
d)8GB以上的堆内存(建议值)
e)停顿时间是500ms以内
什么情况下要打破双亲委派机制?
廖银华
什么情况下要打破?
需要加载同一个class或修改核心类
怎么打破?
使用自定义类加载器,继承classloader 重写loadclass方法。
采用tomcat自定义类加载器。
王静
在同一个jvm中,要加载同一包名和类名的类(比如同一个类的不同版本)时,需要打破双亲委派机制。方法:自定义类加载器重写父类的loadClass方法(打破双亲委派)和findClass方法(加载不同路径)
王天鑫
核心类接口的重写 同类名实现不同时 需要打破双亲委派 自定义类加载器需要继承classlader ,该类有2个核心方法 loadclass(打破双亲委派) findclass(根据名称和位置记载文件)
张启航
比如tomact需要加载多个web服务的时候,需要加载两个类名一样实现不一样的类的时候,就需要打破双亲委派机制,每个web服务自定义ClassLoader,重写loadClass方法,不依照先往父类去寻找类加载器,
张煜浩
同一个应用,实现相同类不同版本之间的相互共存与隔离时,需要打破双亲委派机制。
赵哲
在jvm中,需要加载自定义的类。双亲委派机制会委派父类加载,导致自定义的类无法生效。这种情况需要自定义类加载器。继承classloader方法,重写loadclass加载自定义类时打破双亲委派。
阿紫
在同一个jvm中,要加载同一包名和类名的类(比如同一个类的不同版本), 实现相同类不同版本之间的相互共存与隔离时,需要打破双亲委派机制。
方法:自定义类加载器重写父类的loadClass方法(打破双亲委派)和findClass方法(加载不同路径)
比如tomact需要加载多个web服务的时候,需要加载两个类名一样,实现不一样的类的时候,就需要打破双亲委派机制,每个web服务自定义ClassLoader,重写loadClass方法,不依照先往父类去寻找类加载器,
内存泄露是怎么回事
廖银华
王静
new了一个对象,不用了没有释放,还是让它长时间被一个老年代的对象引用着,gc清理不了,就是内存泄露了,
所以长时间内存储在jvm中不会清理的缓存对象,最好加上数据淘汰算法,让很久不用的数据能自动清理
王天鑫
张启航
过期的资源没有释放,导致内存无法被gc回收,未被释放的空间一直占据内存,可能造成内存溢出
张煜浩
赵哲
阿紫
编写代码时没有想到使用的资源要及时回收,或者误写了错误的代码,就会导致一些已经不再使用的资源依旧被gc roots引用,引起内存泄露。如使用缓存存储对象未使用过期策略,使用io流用完后没把流关闭,还有就是线程池的错误使用。
G1垃圾收集器的gc过程?
廖银华
G1保留了分代的概念
1,初始标记 暂停用户线程找到GCROOT能直接引用的对象
2,并发标记 对gcroot整个对象链路进行遍历进行标记对象
3,重新标记 暂停用户线程由于并发标记并不暂停用户线程而导致对象状态发生变化。这里是为了修正标记。
4,筛选回收 暂停用户线程 预估回收时间,按照限制时间进行回收一部分垃圾,G1对每个regoin的回收成本与时间进行排序,根据用户所期望的回收停顿时间筛选出部分regoin区域回收。
王静
1.初始标记:STW,标记gc roots直接引用的对象
2.并发标记:从gc roots直接引用的对象开始遍历标记其他对象
3.最终标记:STW,修正并发标记期间,程序运行时变动的标记
4.筛选回收:STW,对各个Region的回收价值和成本进行排序,根据用户所期望的GC停顿时间来制定回收计划并回收
王天鑫
初始标记:暂停程序线程、记录gc roots直接引用的对象
并发标记:与应用线程一起执行,进行可达性分析
最终标记:暂停程序线程,修正上一次的的标记结果,使用原始快照(stab)
筛选回收:对region中存活的对象判断回收价值与成本来排序,根据用户期待的gc停顿时间来制定回收计划,优先回收region中存活对象少的
张启航
初始标记:STW,记录GCroot直接引用的对象
并发标记:不STW,GC线程和用户线程同时进行,GC线程根据GCroot找到存活的对象
最终标记:STW,重新标记扫描并发标记阶段发生改变的对象,使用SATB原始快照解决漏标的问题
筛选回收:STW,会对每个region的回收价值和成本进行排序,根据用户期望的停顿时间来优先回收空间小的region
张煜浩
初始标记,并发标记,最终标记同cms的初始标记,并发标记,重新标记过程差不多,接下来是筛选回收阶段:stw,根据设置的期望停顿时间对各个region的回收价值和成本进行计算和排序,优先回收(复制算法)部分region达到时间阈值后,停止回收,剩余的垃圾region在下一次gc再做计算回收。
赵哲
初始标记 stw gc roots能被根节点直接引用的对象。
并发标记 和应用线程一起执行,找到存活的对象。
最终标记 stw,重新扫描并发标记过程中,状态发生改变的标记。
筛选回收 stw暂停用户线程可以设置最大的停顿时间。垃圾回收时会根据每个region区的回收价值和回收成本来排序,在设置的停顿时限内优先回收效益比最高的region区
阿紫
什么是漏标,以及解决方案是什么?
廖银华
在并发标记过程中,因为用户线程同时进行,导致应该被标记的对象由于状态的变化而没标记,这种没被标记的对象会被当做垃圾直接回收掉。
解决方案有两种:增量更新 在三色标记中 当黑色对象插入新指向白色对象引用关系时记录下来,后面重新扫描 原始快照(SATB) 将灰色对象要删除掉和白色对象的引用时 记录下这个操作,重新扫描时根据灰色对象重新扫描。
王静
漏标即是在并发标记阶段,因为用户线程运行导致还存活的对象未被标记。
已扫描对象插入未被扫描的对象的引用产生有两个条件:1.未被扫描的对象引用被删除了 2.这个被删除引用的对象被黑色对象引用了。
两种解决办法:1.在对象引用被删除时,使用SATB记录对象引用 2.在对象被黑色对象引用时,使用增量更新方法记录对象引用
还有一种漏标是并发标记和并发清理阶段用户线程新增的对象,直接标记为黑色
王天鑫
漏标是指灰色指向白色对象引用消失了,然后一个黑色对象重新引用了这个白色对象 cms使用增量更新(将新插入的引用记录下来,等并发标记后将新的引用关系以黑色对象为根,重新标记,黑色对象变为灰色) g1使用satb(将灰色对象要删除指向白色引用关系记录下来,并发标记后以这个记录引用中的灰色对象为根,重新扫描就会扫到白色对象,将白色对象变为黑色对象,防止后续有其他对象引用)
张启航
漏标就是在并发标记阶段用户线程和GC线程同时进行时,还没有被GC线程扫到对象,断开了引用白色对象的链接,被其他黑色对象新增引用,却没有被扫描到,导致被引用的对象被误删除,CMS垃圾收集器采用增量更新的算法,G1则采用SATB原始快照的算法来解决漏标的问题
张煜浩
漏标:并发标记过程中,黑色对象新增了指向被灰色对象删除引用的白色对象的引用,而黑色对象不会被再次扫描,此时的白色对象即为漏标对象,它是有用对象,不应该被回收。
解决:写屏障+增量更新/SATB。写屏障可理解为类似aop实现。增量更新:记录新增的黑色–>白色对象的引用,并发标记之后,重新扫描黑色对象。SATB:记录被删除的白色对象,将其直接标记为黑色,使其成为浮动垃圾,在本轮gc存活下来,下一次gc重新扫描标记回收即可。
赵哲
在并发标记过程中,黑色对象,下的对象扫描一半,导致该灰色对象的,白色对象漏标。
1 增量更新 记录黑色到白色的对象引用。下次垃圾回收重新扫描这些对象。
2 satb 记录灰色对象下露标的白色对象,将他们直接标记为黑色。谢谢对象成为浮动垃圾在下次垃圾回收时重新扫描。
阿紫
对于一个总是发生oom的线上系统,应该怎么定位到他的问题?
廖银华
王静
1.通过配置jvm参数将程序运行过程中的gc日志全部打印到dump文件中
2.借助gceasy等可视化工具分析gc日志,查出每次gc前后jvm各个区内存变化情况
3.分析java程序运行时内存模型以及对象在各个分区中流转的情况
4.根据对象挪动到老年代的4个规则以及分析的内存模型,判断full gc的原因进行优化,尽量减少full gc以及解决oom问题
王天鑫
张启航
张煜浩
赵哲
阿紫
如果一个系统经常发生oom,最简便的办法是利用阿尔萨斯或者jmap看他的实例情况,但是一般都看不出来,因为你使用这个的时候它已经不oom了。
所以第一个选择是在jvm启动参数上加在oom自动导出dump日志,这个参数建议在上线时就加上,出了问题再加就有些晚了。
将dump日志下载下来,导入到jvisualvm一般都能找到问题原因。因为他会直观的告诉你哪个线程发生了oom。
oom发生的情况还是很苛刻的,要想full gc之后还没有空间,要么就是内存太小还并发很高,要么就是代码有bug,一般都是代码有bug。
剩下的关于去分析gc,做年轻代和老年代的内存调优,是个慢工出细活的事情,一般来说都是尽可能调大年轻代,微调的话效益其实很低的。
如果经常发生full gc的话,出现的情况还是很少,正常情况想出现一直full gc,让朝生夕死的对象进入到老年代了,真的不太可能。比如你的年轻代是1G, survivor区一个区就是100m,从业务角度看,一个对象的存活时间和你的响应时间有关,假设你的响应时间是200ms,那对象的存活时间是在0ms~200ms区间(应用响应完了之后这些对象都是垃圾),那么想要满足full gc的条件,就必须是在200ms内有50m的对象存活,这才能触发动态年龄判断机制,进入老年代。200ms有50m对象存活,一个20个字段的对象是96b(20*4 + 8对象头 + 4类型指针+4对齐填充),这里约定于100b,假设你一次业务需要创建50个对象(很多了吧),那也就是5000b = 5kb, 50m/50kb = 1024, 200ms要处理1024个请求,1s就是5000+请求,一个实例5000qps,你啥系统?所以这很难很难发生。
所以一个系统如果经常发生full gc,那基本只有一个原因,触发了大对象直接进入老年代机制。这时候也是通过jmap看看是哪个对象就行了。
什么是安全点和安全区?以及他们的作用是什么?
廖银华
安全点:GC 线程要开始工作,但是要确保用户线程暂停的这行字节码指令是不会导致引用关系的变化,而需要选择一个地方作为安全点,一般在方法调用,异常跳转这些地方
安全区:这种区域主要是考虑到线程的状态处于blocked等时没办法进入安全点,所以安全区就产生了。
王静
安全点是指线程运行到代码中一些特定的位置时,它的状态是确定的。当所有线程都运行到安全点时,才能触发gc。
安全点的位置一般是方法返回之前,调用某个方法之后,抛出异常的位置,循环的末尾。
安全区域是指在一段代码中,引用关系都不会发生变化。在这个区域任何位置都可以开始gc。
王天鑫
安全点与安全区域:安全点可以保证当时执行状态下虚拟机的堆栈信息不会变化更方便垃圾回收。当线程睡眠或者中断时,使用安全区来保证这段代码的引用不会发生变化。 方便jvm的垃圾回收。安全点一般的位置在,方法返回前、方法调用后、异常抛出位置、循环的末尾
张启航
安全点是线程运行到可以暂停的位置,在垃圾收集时,程序只有到达安全点才能stw,安全区域指在一段时间内引用关系不会发生变化,因此在安全区域内任何时间进行垃圾收集都是安全的
张煜浩
安全点与安全区域:防止一些原子操作执行被破坏。
gc的触发条件之一,需要等待所有用户线程运行到安全点后才能触发。
安全点位置:方法返回之前/方法调用之后/异常抛出位置/循环末尾 等。
安全区域:一段代码片段中的引用关系不会发生变化。这个区域内的任意地方去开始GC都是安全的。
赵哲
小雪
安全点 是线程运行到可以中断或者挂起的位置,安全区域比如说一个线程执行sleep代码那时候就算执行其他不会有影响 作用是 保障进行gc的时候是安全的不会对线程造成其他影响
阿紫
安全点一般是在:方法返回前、方法调用后、异常抛出位置、循环的末尾。为什么JVM要选择在这些地方作为安全点呢?像这种int a = 1的地方为啥不行?
stw就是让用户线程暂停嘛,这里就有个问题,用户线程怎么才能知道我要暂停了?
如何让用户线程暂停有两种方法,一个就是jvm主动通知用户线程暂停,另一个就是让用户线程自主询问是否要暂停。
jvm主动通知用户线程暂停有个极大的缺陷,jvm也不知道线程到没到安全点,万一没到,等会又要通知一下。
就像有人问你:到没到?
你说:没到。
过了一会他又问你:到没到?
你说:没到。
过了一会他又问你:到没到?
你说:tmd都说了没到。
过了一会他又问你:到没到?
你说:过了。
所以他就换了种方法。你自己来问我要不要停。
就像你问他:要不要停?
他说:不用。
过了一会你再问他:要不要停?
他说:要。
好,你就停下。
但是你也不能走一步就问他吧。好歹在转角遇到岔路口之类的再问撒。
不然他就会非常恼火:你他娘的走一步就问一下,走一步就问下,你烦不烦!
你也非常恼火:走一步就要问一下,走一步就要问一下,真是xxx了!
安全点就是岔路口,这种将会进行长指令的地方,比如要调用某个方法了,要执行for循环了。
走一步就是短指令。
安全点和安全区的作用发生在需要线程停止的地方。
如何自定义类加载器,加载自定义类的来源有哪些?
延伸一个入狱小技巧:应用部署在A服务器上,开发人员没有权限操作这台服务器。问:开发人员怎么样才能在不重新发布的情况下,偷偷的替换掉应用的代码逻辑?比如把退款的账号都改成自己的。
廖银华
继承classlader类,重写findclass方法, loadclass方法实现了双亲委派。
在xxljob遇到过 这种,它的逻辑是固定一个编辑窗口 Web IDE写入脚本,并且可以使用spring的注入注解。实时可以更新文件内容,并编译成class文件由自定义类加载器Groovy类加载器 进行加载,实例化成Java对象。
王静
通过重写父类Classloader的 findClass方法实现自定义类加载器,加载指定路径下的类。加载自定义类的来源是什么意思,没看懂。 入狱小技巧:查了一下,可以在运用代码集成arthas,然后运用在服务器上部署之后,本地通过arthas tunnel远程连接操作使用ongl命令修改变量
王天鑫
自定义类加载器需要继承java.lang.ClassLoader 类,重写findClass方法。
来源是因为需要打破双亲委派,所以出现了自定义类加载器
张启航
继承ClassLoader类,重写findClass方法
张煜浩
自定义类加载器:集成ClassLoader类,重写其findclass方法,其中返回的defineclass是将class文件的字节数组转化为class对象
赵哲
小雪
阿紫
JVM运行时数据区的组成部分有哪些?
廖银华
堆,垃圾回收重点区域 存储对象
栈,里面放着栈桢 栈桢里有局部变量表,操作数栈,动态链接,方法出口
本地方法栈,Native方法区
方法区:存放已被虚拟机加载的类信息、常量、静态变量等等数据
程序计数器:当前线程执行的行号指引器
王静
堆:主要用来存放对象,字符串常量池,线程共享。
方法区:class文件加载到内存中存放的位置。主要存放静态变量,常量,类元信息等,线程共享。
栈:主要包括方法栈,程序计数器,本地方法栈。方法栈中由多个栈帧组成,每个栈帧包括方法出口,局部变量表,操作数栈,动态链接。一个线程对应一个栈,栈是每个线程独有。如果对象分配内存时经过了逃逸分析和标量替换,也可以分配在栈帧中。
王天鑫
堆:线程共享,存放new出来的对象和字符串、字符串常量池
方法区:线程共享,存放常量、静态变量、类元信息、运行时常量池
栈:线程私有,局部变量表、操作数栈、动态链接、方法出口
本地方法栈:线程私有,存放native方法
程序计数器:线程私有,当前线程所执行的字节码的行号指示器,用于记录正在执行的虚拟机字节指令地址
张启航
张煜浩
线程私有:虚拟机栈、本地方法栈、程序计数器。线程共享:堆,方法区。
虚拟机栈:由一个个栈桢组成,一个方法就是一个栈桢。而一个栈桢里面又分为局部变量表、操作数栈、动态链接、方法出口。
本地方法栈:存放native方法的相关信息。
程序计数器:字节码指令的行号(指针),由执行引擎修改。
堆:几乎所有new出来的东西+字符串常量池。
方法区:类元信息,常量、静态变量,运行时常量池。
赵哲
堆 线程共享 存放所有对象、字符串常量池
方法区 线程共享 主要存放常量 静态变量 类信息 运行时常量池
线程私有
栈 存放局部变量、操作数栈、方法出口
本地方法区 native 的方法
程序计数器 运行时字节码指令的记录器
小雪
堆:是所有线程共享的一块内存区域,虚拟机启动时候创建,存储对象实例,堆在虚拟机内又被划分年轻代 老年代
栈 :是线程私有,先进后出,里面包含操作数栈,局部变量表,动态链接,方法出口
本地方法栈:存放native修饰的方法,主要是c++在执行
方法区:线程共享,运行时常量池,常量,静态变量,类信息
程序计数器:线程私有,主要用于定位,方便切换,存的是当前计数,而不是++后的计数
阿紫
Spring
Spring创建Bean过程中的大致做了哪些事?
廖银华
第一步:扫描 按照componentscan指定路径
第二步:用asm读取类信息。
第三步:校验Canditional或fifitle等等这些条件注解beandifinition
第五步根据beandifinition创建bean ,
留步:单例?懒加载?抽象?根据beandifinition创建bean,推断构造,创建实例对象,依赖注入,属性填充,post 初始化前 ,初始化 初始化后代理
王静
推断构造方法—>创建普通对象—>依赖注入(@Autowired属性赋值)—>初始化前(@Postconstruct)—>初始化(instance of InitializeBean)—>初始化后—>遍历Aop切面对象判断该类是否有方法被代理—>(有)创建代理对象—>bean
王天鑫
创建选中有参唯一或无参构造方法,创建实例对象,
依赖注入:是否存在被@autowired注解的属性
aware回调:是否实现了BeanNameAware接口、 BeanClassLoaderAware接口、BeanFactoryAware接口
初始化前:是否存在被@PostConstruct注解的方法,存在则调用当前对象方法
初始化:是否实现了InitializingBean接口,实现了则调用afterPropertiesSet()方法
初始化后:判断是否进行aop,不需要则完成,需要则生成代理对象
张启航
推断构造方法,创建普通对象,填充属性,初始化前,初始化,初始化后
张煜浩
推断构造方法,创建实例对象。依赖注入。Aware回调。初始化前。初始化。初始化后。
赵哲
创建实例对象–依赖注入–加载依赖类的属性–初始化前 加载前置的方法–初始化对象 是否有接口实现 – 初始化后 – 判断是否有aop切面,生成代理对象(如果有代理则使用代理对象)
小雪
阿紫
简述一下如何手写一个简单的Spring,只实现扫描和创建Bean的过程
廖银华
spring关键的在于需要 扫描 生成beandefinition 并用beandefinition生成bean,
扫描:需要获取路径 ,类似于ComponentScan注解。创建一个启动器,将放有componentSacn注解的类class传入进去,利用反射获取componentSacn中的路径值。再根据路径值去扫描相应类并通过类加载器进行加载(源生spring是用的asm获取类信息),并查看被加载出来的类是否被加了需要注入的注解,如果加了就解析出类信息 比如类创建的方式 或作用域等等生成beandifinition对象放进一个类信息缓存池。
后面就是创建bean:
创建bean 先通过构造方法获取一个实例对象,查看哪些对象需要注入(类似@Value @Autow等等注解),注入后可以添加后置方法了这里可以创建Aware接口进行回调,实现@post注解就在这里发生。然后再创建一个了InitiBean接口,这个接口有一个必须实现的方法afterPro 可以通过这个方法对bean进行修改操作或其他操作。最后就是通过代理 对相应bean做代理(这里也有判断 是否需要代理。可以通过特定的注解来判断@Before等等),然后将这些使用了注解的方法放到代理类按顺序执行就行了。
王静
自定义ApplicationContext类,在构造方法中传入Appconfig配置类
扫描:
1.判断配置类是否使用ComponentScan注解,如果实现,获取注解值,通过appClassLoader的getResource方法传入相对路径(注解值转化),获取到扫描路径
2.遍历扫描路径下所有文件,使用classLoader加载文件,判断是否使用Component注解,是则继续
3.判断class是否实现BeanPostProcessor接口,是则实例化该类然后放入beanPostProcessorList链表中
4.如果没有实现实现BeanPostProcessor接口,创建BeanDefinition然后放入BeanDefinitionMap
创建:
1.遍历BeanDefinitionMap
2.从BeanDefinition中获取class,使用推断构造方法创建实例
3.遍历class的所有属性,对使用了Autowired注解的字段赋值(根据属性类型和名称,getBean(),判断是否为单例Bean,是就单例池中查找,找不到createBean()放入单例池,原型bean直接createBean())
4.判断Bean是否实现xxAware接口,有则强制转化类型调用方法重写的setxx方法
5.遍历所有实现了beanPostProcessorList,调用postProcessBeforeInitialization方法
6.判断bean是否实现InitializingBean接口,如果实现,调用afterPropertiesSet方法
7.遍历所有实现了beanPostProcessorList,调用postProcessAfterInitialization方法(可以实现AOP)
8.创建完成后,bean放入单例池singletonObjects
王天鑫
张启航
张煜浩
扫描干的事:扫描指定包路径下的所有类,寻找其中被component注解了的类,判断其是否是beanpostprocessor接口的实现类,是的话要将其add进集合中,待创建bean过程使用;同时被component注解了的类,要将其封装为beandefinition对象(类型,作用域,是否懒加载等属性),存入key为beanname,value为此对象的map中。
创建bean:根据beandefinition得到其class对象,利用反射创建对象(此过程需要推断构造方法),完了以后获取class类中的属性,挨个赋值(依赖注入)。Aware类似初始化实现。接着就是遍历扫描过程准备好的beanpostprocessor集合,如果比class在其中,就调用其before方法(初始化前)。判断此class是否实现initializXXX接口,实现的话调用其内的那个post什么什么方法(方法名记不清)。最后再次遍历扫描过程准备好的beanpostprocessor集合,如果比class在其中,就调用其after方法(初始化后)。
赵哲
小雪
spring创建过程
1、扫描:
1.1通过ComponentScan注解可以定义扫描的包路径
1.2遍历加载里面的类文件,将含有Component修饰的类封装为BeanDefinition对象(type和scope属性等),统一放在beanDefinitionMap中
1.3若是继承BeanPostProcessor的,则直接实例化,放到list中
2、创建:
2.1 遍历beanDefinitionMap,根据type获取class,使用构造创建对象实例
2.2 遍历class的属性,有@AutoWired的进行依赖注入,这个期间可以getBean();通过scope判断,是单例的判断是否已经加载过,也就是是否在单例池中,若存在可以直接使用,就不需要走创建逻辑,相当于一个缓存
2.3 判断是否有回调Aware,有调用里面对应方法
2.4 初始化前,遍历所有beanPostProcessor,执行postProcessBeforeInitialization方法
2.5 初始化,执行afterPropertiesSet方法
2.6 初始化后,执行postProcessAfterInitialization方法
3、创建完毕,单例对象放入单例池中
阿紫
如何在Spring扫描注解中加入自定义的注解,比如Spring默认支持标识Component注解的类为Bean,我现在有个@User注解,我想让Spring扫描到标识了@User注解的类也当做bean,怎么做?
廖银华
用includeFilters来完成,可以选择指定的注解,也可以指定自定义过滤器(实现TypeFilter接口)。
王静
扫描的时候ComponentScan注解,配置includeFilter,过滤类型设置为annotation,class配置成User.class,将包含User注解的类也过滤出来,扫描到然后生成Bean
@ComponentScan(value = “com.xxx”,
includeFilters = {@ComponentScan.Filter(
type = FilterType.ANNOTATION,
classes = User.class)})
王天鑫
张启航
张煜浩
赵哲
小雪
阿紫
如何才能让FacotryBean类对应的两个bean在spring启动的时候就生成, 不准通过实现SmartFactoryBean接口的方式完成
王静
把这个工厂类作为其他单例bean属性,加autowired注解,那样属性注入的时候,getbean的时候就生成了.
自定义一个代理类,初始化后方法里判断这个类是不是factorybean,是的话手动去调用getBean
初始化前和初始化的时候也可以
依赖注入自己注入自己也可以
什么是BeanDefinition,以及什么情况会发生BeanDefinition的合并?
廖银华
beandefinition字面意思是Bean的定义,统称为元信息包括它的行为包含了作用域、bean名称、bean类型等等,
从结构来讲他是一个接口,有很多实现类。可以理解为最终bean形成的中间站。
当bean配置了parent属性的时候,会去检查是否有父类的beandifition。在检查的时候会有一个递归操作
王静
BeanDefinition存放的是bean的相关信息,类名,类元数据等。主要用于扫描类之后再还未生成bean之前保存类信息。
当BeanDefinition存在parent的时候,在扫描完之后会进行BeanDefinition的合并,将父BeanDefinition的属性继承给子BeanDefinition,如果有相同属性,子BeanDefinition属性会覆盖
王天鑫
张启航
张煜浩
beandefinition接口封装定义了baen的一些基本属性信息,方便spring容器对一个bean的行为操作。两个或多个beandefinition之间存在parent属性关联关系时,需要这些个beandefinition进行merge合并,生成一个新的rootbeandefinition去使用,比如扫描完成之后实例化非懒加载的单例bean时就用到了。
赵哲
小雪
beandefinition是在扫描后生成的一个对象,里面包含类信息原型还是单例,是否懒加载等,当扫描完成后用它去创建对象
当多个beandiefinition中存在父级关联关系,会基于多个另外构建一个合并beandefinition出来,其中属性一致的值不一致的使用子级的值
阿紫
ApplicationContext和BeanFactory的区别是什么?
廖银华
ApplicationContext是BeanFactory子类,他比beanfactory提供了更多的方法,比如:时间发布,资源加载,国际化。
beanFactory我认为他专注于获取Bean的信息和创建Bean,而ApplicationContext更加注重于流程化,像在AbstractApplicationContext这个类去注入单例Bean的时候其实是用Beanfactory的实现类去做的,而不是ApplicationgContext的实现类
王静
ApplicationContext接口继承了ListableBeanFactory, HierarchicalBeanFactory,所以也继承了这两个接口的父接口BeanFactory,拥有BeanFactory管理和创建Bean的功能。同时因为ApplicationContext接口还继承了EnvironmentCapable,MessageSource, ApplicationEventPublisher, ResourcePatternResolver接口,所以还拥有这些接口对应的功能:获取运行时环境,国际化,时间发布,资源加载。
王天鑫
张启航
张煜浩
都是接口,ApplicationContext继承了BeanFactory的子接口,因此它实际上就是BeanFactory,但是ApplicationContext的功能更加强大,比如:类型转换、资源获取、事件发布、国际化等。
赵哲
小雪
阿紫
BeanFactory充分体现了工厂方法设计模式,屏蔽了所有关于对Bean操作的细节,包括但不限于注册BeanDefinition, 创建Bean。
而ApplicationContext更多关注于应用层,贯穿了Spring的整个流程,它将Spring的所有功能整合,以门面模式向外提供其他功能的方法。
Spring创建bean时的寻找注入点过程是怎样的?只说AutowiredAnnotationBeanPostProcessor的流程就行。
廖银华
先判断Bean类型是否是String,然后遍历所有属性,查看属性上面是否有@Autowired、@Value、@Inject中的其中一个,且这属性不能是静态的(静态不能自动注入),找到构造注入点。再后遍历所有方法查看方法上面是否存在@Autowired、@Value、@Inject中的其中一个,同样静态方法不能进行自动注入。这个外面还有一层do while 会对父类进行同样的操作
王静
王天鑫
张启航
张煜浩
1,一个Bean的className是以"java."开头,或者Ordered类型,则不需要进行依赖注入,返回空对象。
2,遍历当前类中所有的field,找出@Autowired、@Value、@javax.inject.Inject这些注解,如果有且注解的不是静态属性,则当前注解构建注入点。
3,遍历当前类中所有的method,如果是桥接方法,不需要进行依赖注入;如果不是,找出@Autowired、@Value、@javax.inject.Inject这些注解,如果有且注解的不是静态方法(不管有没有参数),则当前注解处构建注入点。
4,完了以后,以同样的逻辑去父类中找,找到就构造注入点,父类的注入点排在子类的前面。
赵哲
小雪
阿紫
单例bean创建过程中如果依赖了懒加载的bean,这个懒加载的bean会立即被创建出来吗?
说一下Bean的生命周期有哪些流程?
廖银华
InstantiationAwareBeanPostProcessor.postProcessBeforeInstantiation()
实例化
MergedBeanDefinitionPostProcessor.postProcessMergedBeanDefinition() InstantiationAwareBeanPostProcessor.postProcessAfterInstantiation()
自动注入 InstantiationAwareBeanPostProcessor.postProcessProperties()
Aware对象 BeanPostProcessor.postProcessBeforeInitialization()
初始化 BeanPostProcessor.postProcessAfterInitialization()
王静
1.ClassLoader加载class
2.实例化前,遍历InstantiationAwareBeanPostProcessor,执行postProcessBeforeInstantiation()方法,如果返回对象则直接执行初始化后方法然后返回bean不再进行后续操作
3.实例化:根据RootBeanDefinition创建bean
4.BeanDefinition后置处理:遍历MergedBeanDefinitionPostProcessor,执行postProcessMergedBeanDefinition()方法,可以修改RootBeanDefinition里面的属性,比如增加属性值
5.实例化后:遍历InstantiationAwareBeanPostProcessor,执行postProcessAfterInstantiation()方法
6.Spring自动注入(autowire=byName/byType, 存在set方法)
7.依赖注入:遍历InstantiationAwareBeanPostProcessor,执行postProcessProperties()方法,处理@Autowired、@Resource、@Value等注解
8.Aware回调:判断是否实现BeanNameAware,BeanClassLoaderAware,BeanFactoryAware,增强bean的感知(beanFactory、beanClassLoader等)
9.初始化前:遍历所有BeanPostProcessor,执行postProcessBeforeInitialization()方法,返回Object作为bean继续处理,可对bean进行修改
10.初始化:如果bean实现InitializingBean,执行afterPropertiesSet()方法
11.初始化后,遍历所有BeanPostProcessor,执行postProcessAfterInitialization()方法,返回Object作为bean继续处理,可对bean进行修改(AOP返回代理对象)
12.bean销毁:注册到disposableBeans,(bean继承DisposableBean或AutoCloseable实现销毁方法 或 有DestructionAwareBeanPostProcessor)
王天鑫
张启航
张煜浩
类加载,实例化前,实例化,mergexxxbeanpostprocess方法调用(可以对beandefinition属性手动赋值(必须有set方法)等),属性填充(实例化后,依赖注入(spring自带,注解注入)),初始化(aware回调,初始化前,初始化,初始化后)
赵哲
小雪
1.标记一下正在创建
2.实例化前,确保下beanclass被加载了
3.实例化前,若实现了instantiationAwareBeanPostProcessors,执行里面的postProcessBeforeInstantiation方法
4.实例化(涉及推断构造)
5.若实现了MergedBeanDefinitionPostProcessor,执行postProcessMergedBeanDefinition方法可以对合并后的beandefinition处理
6.实例化后,若实现了instantiationAwareBeanPostProcessors,执行里面的postProcessAfterInstantiation方法
7.属性填充,依赖注入,注入后会记录map比如:A被B依赖了,防止循环依赖。有两种
7.1 spring自带的,需要给属性设置set方法
7.2 判断是否实现instantiationAwareBeanPostProcessors,执行里面的postProcessProperties方法给对象的属性赋值
若当前beandefinition中设置了propertyValues将是propertyValues中的值覆盖@Autowired
8.Aware回调,判断是否实现BeanNameAware BeanClassLoaderAware BeanFactoryAware,执行对应的方法
9.初始化前执行实现了BeanPostProcessor接口中的postProcessBeforeInitialization方法
10.初始化,执行实现了InitializingBean接口的afterPropertiesSet方法,若有自定义的执行自定义代码
11.初始化后,执行实现了BeanPostProcessor接口中的postProcessAfterInitialization方法
12.bean销毁
13.移除正在创建标志
阿紫
bean销毁过程,以及有什么应用场景?
廖银华
线程池回收,长连接销毁?
王静
bean生命周期初始化步骤后,判断当前bean是否为DisposableBean(指定销毁方法),是则加入disposableBeans:
判断条件:
1.实现DisposableBean接口
2.实现AutoCloseable接口
3.bean定义设置销毁方法destroyMethod
4.实现DestructionAwareBeanPostProcessor接口,requiresDestruction()方法返回true
在容器正常关闭时(context.close()或context.registerShutdownHook()):
把disposableBeans中所有的bean取出销毁(指定了销毁方法的bean)
单例bean销毁过程:
1.将bean从单例池中移除
2.从disposableBeans中移除
3.在销毁当前bean之前,递归调用destroySingleton销毁依赖当前bean的所有单例bean
4.执行bean的destory方法(DisposableBeanAdapter),bean的销毁阶段回调顺序:@PreDestroy → DisposableBean → destroyMethod
a.遍历DestructionAwareBeanPostProcessor,执行postProcessBeforeDestruction()
b.((DisposableBean) this.bean).destroy()
c.invokeCustomDestroyMethod(this.destroyMethod),指定的销毁方法
5.销毁bean中bean(嵌套 bean)
6.删除当前bean的依赖和被依赖关系
王天鑫
张启航
张煜浩
赵哲
小雪
bean销毁有很多出发条件,
比如
1.实现了disposablebean,重写destory接口
2.实现了AutoCloseanle接口,
3.使用了注解@PreDestory;
4.在mergeddefinitionpostprocessor里给beandefinition赋值setDestoryMethodName(“(inferred)”)后在bean里面也写了close()方法
5.bean实现了DestructionAwareBeanPostProcessor,并且requiresDestruction方法返回true
以上容器关闭的时候会触发
还有一种spring boot的时候用的会注册一个关闭钩子,jcm进程关闭的时候调用
阿紫
线程池shutdown是常见的案例。
停止的时候你想向外发个消息都行。
或者你有个定时任务,每5s刷盘,为了防止数据丢失,你可以停止的时候再刷一次盘。
微服务架构,服务停止的时候会通知注册中心,取消注册。免得还得注册中心经过心跳机制才发现这个服务挂了。